Proyecto LYNEAL
Introducción
El proyecto LYNEAL (Letras y Números en Análisis Lingüísticos) constituye el marco computacional y metodológico sobre el que se articula El Léxico del Quijote. Se basa en los principios de la Filología Digital y las Humanidades Digitales, combinando herramientas informáticas avanzadas para el procesamiento del lenguaje natural con el rigor de la crítica textual. A través del entorno y la aplicación web de LYNEAL, se gestiona la base de datos del texto cervantino y se permite tanto la corrección y estructuración de los datos como su consulta analítica e interactiva en línea.
El Léxico del Quijote es un innovador recurso digital de acceso abierto en la plataforma Madroño de la Universidad Autónoma de Madrid que reúne, por primera vez en más de 400 años de estudios cervantinos*, una sistematización exhaustiva del vocabulario de la obra cumbre de Miguel de Cervantes. A diferencia de las listas de frecuencias de palabras existentes con anterioridad, esta obra organiza el caudal léxico por lemas (las formas canónicas que encabezan los diccionarios y agrupan todas las variantes y flexiones morfológicas de un término, como tiempos y personas verbales).
Este trabajo ha sido posible gracias a un grupo de lingüistas coordinados por Antonio Moreno Sandoval (UAM) y Hiroto Ueda (Tokio). Hay especialistas en lingüística computacional, literatura e historia del español de diferentes universidades (Alcalá, Complutense, Granada…). Se trata de una colaboración multidisciplinar que se ha desarrollado durante 7 años, principalmente a distancia. Comenzó justo antes de la pandemia y se ha podido completar mediante la metodología de Filología Digital y programas computacionales para el tratamiento del español.
*Los estudios cervantinos y la recepción crítica de Don Quijote de la Mancha comenzaron inmediatamente tras la publicación de su primera parte a principios de 1605 (impreso por Juan de la Cuesta y publicado en Madrid). [1, 2, 3]. Las primeras alusiones críticas y parodias literarias surgieron de inmediato en ese mismo año de 1605. Entre las primeras huellas documentadas de su impacto y lectura crítica se encuentran los ecos y burlas en obras contemporáneas del Siglo de Oro, como las alusiones de Lope de Vega en su correspondencia y textos (quien ya mencionaba la obra y competía en el ambiente literario madrileño) o las referencias en la picaresca de la época (por ejemplo, en el entorno de La pícara Justina, publicada también en 1605 y atribuida a Francisco López de Úbeda). Durante el siglo XVII y XVIII la obra fue leída principalmente como un libro cómico o satírico, hasta que en el siglo XVIII los eruditos extranjeros y locales —como el británico John Bowle en 1781 o Diego Clemencín con su famoso comentario de 1833— inauguraron la filología y el comentario crítico moderno sobre el texto cervantino.
Acceso a los diccionarios:
El repertorio incluye:
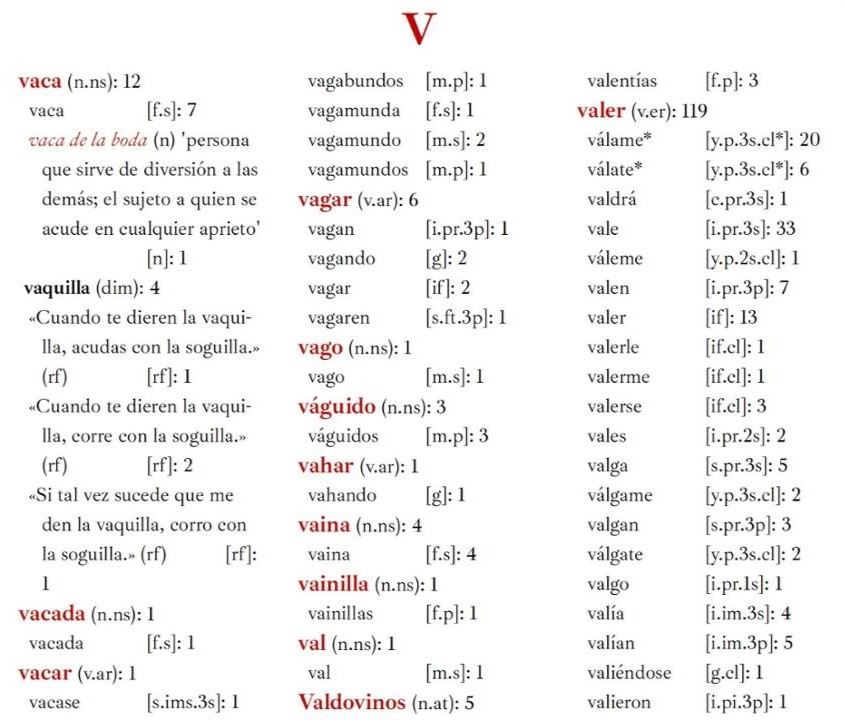
Lematización exhaustiva: Un lema es la palabra canónica que encabeza cada entrada de diccionario y agrupa bajo ella todas sus variantes morfológicas y formas flexionadas (por ejemplo, bajo la entrada del infinitivo amar se integran tiempos y personas como amo, amas, amó, etc.). Esta organización saca a la luz la verdadera riqueza léxica del texto sin dispersiones formales.
Frecuencias de aparición: Registra el número exacto de veces que aparece cada término, forma o lema en el texto.
Anotación morfosintáctica y rasgos gramaticales: Cada voz detalla su categoría sintáctica junto con especificaciones morfológicas precisas (género, número, persona gramatical y tiempo verbal).
Fraseología y paremiología: Incorpora locuciones, frases hechas y refranes (etiquetados con la marca
rf), acompañados en casos pertinentes de explicaciones contextuales de su significado (como en la expresión vaca de la boda).Marcación diacrónica: Las variantes o formas arcaicas se identifican visualmente con un asterisco (*), permitiendo diferenciar estadios evolutivos del idioma dentro de una misma entrada (por ejemplo, en el lema valer).
Resultados y recursos
Estructura de personajes
La separación del texto en segmentos con las palabras del narrador y de todos los personajes nos ha permitido, en primer lugar, saber cuántos personajes contiene la obra (214) y el detalle de las palabras que dice cada uno, lo que da una idea de su peso dentro de la obra.
La proporción de palabras de los principales participantes es la siguiente:
- Narrador (133.566 palabras, 35% del total),
- Quijote (73.874 palabras, 20%),
- Sancho (47.823, 13%)
- El cautivo Ruy Pérez (12.493, 3%),
- Cardenio (7.244, 2%),
- cura (5.728, 1,5%).
El Quijote en números:
– Número total de palabras del Quijote (versión utilizada): 377.414
– Número total de entradas (lemas) del diccionario: 8.555
– Número total de formas diferentes del diccionario: 22.150
– Número total de personajes: 214
Para hacerse una idea de la riqueza léxica que suponen estas cifras, basta con saber que en el uso normal se emplean alrededor de 3.500 palabras, el vocabulario necesario para alcanzar un nivel B2 en un examen de lengua extranjera.
La «quijotización de Sancho» en datos
Es conocido que tanto Quijote como Sancho aumentan su participación léxica de la primera a la segunda parte. Así, el Quijote sube del 9% al 11% (total 20%) mientras que Sancho duplica su participación (del 4% al 9% para llegar al 13% total). Esto nos lleva a afirmar que se produce más bien una «quijotización de Sancho» que una «sanchificación del Quijote», según la terminología de Madariaga.
Huellas léxicas exclusivas y campos semánticos
Otro resultado del estudio es conocer las palabras exclusivas y propias de los principales personajes, en comparación entre ellos:
Las palabras propias del Quijote: Amadís de Gaula (frecuencia: 26), belleza (15), castellano (14), afrentar (13), premio (13), venidero (11), acción (10), comedia (10), espíritu (10), honestidad (10), poderoso (10)… todas ellas cultas y relacionadas con la caballería andante.
Las palabras propias de Sancho: bolsa (7), olla (7), tocino (7), Ricote (6), avellana (6), cola (6), jugar (6), podrir (6), queso (6), saco (6)… palabras de la vida cotidiana propias del estilo llano.
Los campos semánticos son conjuntos de palabras de la misma categoría gramatical (nombres, verbos, adjetivos) que comparten rasgos de significado comunes y están relacionadas temáticamente. A partir del diccionario completo de lemas, estamos recopilando nombres de instrumentos musicales, profesiones, tejidos y vestimentas, etc. Esto proporciona un rico inventario de conceptos que existían en la época de Cervantes.
Variación diacrónica: el caso mesmo vs. mismo
Otros análisis estilométricos abordan la alternancia entre variantes arcaicas y modernas. Por ejemplo, «mesmo» y «mismo» pertenecen al lema mismo, siendo la primera propia del español medieval y la segunda una innovación que finalmente predominó. Así, «mesmo» se usa más en la Primera parte (1605) y «mismo» en la Segunda (1615). Esto muestra que este cambio está en proceso de transición en esos años. Es aún más interesante que tanto el Quijote como el narrador prefieran claramente la variante «mesmo» propia del español medieval.
Además, al examinar el uso de ambas variantes por género, se observa que los personajes masculinos muestran una preferencia marcada por «mesmo», mientras que las mujeres muestran una ligera inclinación hacia la forma más moderna. Estos hallazgos sugieren que el habla masculina conserva un carácter más tradicional en la obra, en comparación con la femenina. También se observa esta tendencia en diferentes grupos de edad, en los que los mayores prefieren «mesmo». En resumen, en la obra, «mesmo» se asocia principalmente con el personaje principal, el habla masculina y el narrador.
Reflexiones finales
Esta estructuración en unidades discretas y enriquecidas no solo ha facilitado la creación de un diccionario de frecuencias de formas y lemas muy preciso, sino que constituye la arquitectura de datos necesaria para la implementación de tecnologías avanzadas, como los grafos de conocimiento y los sistemas de RAG. En los próximos 12 meses desarrollaremos un chatbot para consultar la obra de Cervantes, como parte del proyecto GRESEL.
Esto es una muestra de lo que se puede lograr con un análisis cuantificado y organizado por personajes. Esperamos que esta serie de diccionarios propicie nuevas investigaciones y comparaciones que amplíen el conocimiento sobre la riquísima obra cervantina.
Ciencia abierta
Desde la elección de la edición digital hasta la creación de la aplicación web de consulta, todos los diccionarios se ofrecen al público sin restricción alguna en su uso.
Para la publicación de los diccionarios, se utiliza el Repositorio de Datos del Consorcio Madroño. Los datos de los diccionarios están bajo una licencia que permite la redistribución y la reutilización de la obra, con la condición de que los creadores sean mencionados y que no se utilice con fines comerciales.
La publicación digital ofrece dos beneficios principales: a) acceso inmediato a los diccionarios y a la obra, lo que facilita considerablemente el análisis para los usuarios; y b) una actualización ágil de las versiones corregidas de los diccionarios, sin coste adicional en su producción, que puede gestionarse con rapidez.
Acceso a los diccionarios:
Cómo citar:
- Moreno-Sandoval, Antonio; Ueda, Hiroto, 2026, «Prefacio a la serie Léxico del Quijote», https://doi.org/10.21950/O80KQR, e-cienciaDatos, V1
- Moreno-Sandoval, Antonio; Ueda, Hiroto, 2026, «Lema, sublema y forma: formas en orden gramatical», https://doi.org/10.21950/TDJZIQ, e-cienciaDatos, V1
- Moreno-Sandoval, Antonio; Ueda, Hiroto, 2026, «Lema, sublema y forma: formas en orden alfabético», https://doi.org/10.21950/S641LW, e-cienciaDatos, V1
Metodología
La metodología integra el tratamiento automático del lenguaje natural y la revisión manual minuciosa:
Edición textual de referencia: Se tomó como texto base la edición crítica (en formatos impreso y digital) preparada en 1996 por los profesores Florencio Sevilla y Antonio Rey, del Departamento de Filología Hispánica de la UAM. La elección obedeció a dos criterios:
Su accesibilidad y disponibilidad en soporte electrónico para uso público.
Su fidelidad lingüística: preserva intactas las grafías y formas originales de la edición princeps, garantizando que el análisis refleje el estado real de la lengua de la época.
Procesamiento y lematización computacional: El análisis morfosintáctico inicial se encomendó al etiquetador automático GRAMPAL. Al tratarse de un sistema diseñado originariamente para el español contemporáneo, requirió un importante proceso de adaptación diacrónica para procesar la prosa del siglo XVII:
Brecha léxica histórica: En los ensayos iniciales se detectó que el lexicón no reconocía alrededor de 4.000 formas presentes en la narrativa cervantina. Entre ellas figuraban: arcaísmos léxicos (como agora), amalgamas y contracciones (como della o desta), variantes gráficas áureas (como fee o experiencia) y tiempos y desinencias verbales obsoletos.
Ampliación del analizador: Se calculó la necesidad de expandir el léxico interno de GRAMPAL con entre 6.000 y 8.000 nuevas entradas adaptadas a la lengua clásica.
Programas de apoyo complementarios: Por razones de tiempo y optimización computacional, la lematización automática se reforzó con herramientas informáticas adicionales especializadas en la detección de variantes diacrónicas y en el reconocimiento de nombres propios (antropónimos y topónimos), de enorme densidad y complejidad a lo largo de toda la obra.
Revisión filológica manual: Las herramientas de procesamiento automático presentan un margen de error próximo al 10 %. Para subsanarlo, el equipo de lingüistas del proyecto LYNEAL examinó y corrigió manualmente cada discrepancia, asegurando la precisión filológica y reduciendo a niveles mínimos los errores de la base de datos final.
Modelado sociolingüístico relacional: Otra aportación significativa de este Léxico del Quijote es que, bajo la dirección de Hiroto Ueda, el resultado se ha plasmado en una base de datos que permite asociar cada frase con el personaje que la pronuncia. Así, es posible vincular las características sociolingüísticas concretas de los personajes, como sexo, edad y clase social, con su vocabulario y su forma de hablar, lo que permite realizar estudios léxicos comparativos. Por ejemplo, cuáles son las palabras distintivas del Quijote en relación con Sancho; qué conceptos predominan en los personajes cultos y en los de clase baja; o incluso las diferencias y semejanzas entre el lenguaje de las mujeres y el de los hombres en la obra cervantina. Además, la base de datos es el elemento clave del proyecto, ya que en ella se realizan todas las correcciones y modificaciones para, posteriormente, generar el lexicón final.
Divulgación
Noticias en prensa
- Caballero, Á. (2026, abril 22). Cervantes usaba el triple de palabras que tú: El primer léxico completo del «Quijote» revela su gran riqueza lingüística. RTVE.es. https://www.rtve.es/noticias/20260422/primer-lexico-quijote-riqueza-espanol-cervantes/17028355.shtml
- Sertal, C. (2026, abril 30). «Mantener palabras de ‘El Quijote’ en el gallego ha sido una opción escogida por los hablantes». Faro de Vigo. https://www.farodevigo.es/sociedad/2026/04/30/quijote-parece-llevan-innovacion-lenguaje-129708324.html
Equipo
– Antonio Moreno Sandoval (coordinador) es Catedrático de Lingüística en la Universidad Autónoma de Madrid, director del Laboratorio de Lingüística Informática (LLI-UAM) y director de la Cátedra UAM-IIC en Lingüística Computacional.
– Hiroto Ueda (coordinador) es Profesor Emérito de la Universidad de Tokio y Académico Correspondiente Extranjero de la Real Academia Española.
– María Agujetas Ortiz es investigadora del grupo GITHE de la Universidad de Alcalá de Henares.
– Tomás Albaladejo Mayordomo es Catedrático Emérito de Teoría de la Literatura y Literatura Comparada de la Universidad Autónoma de Madrid.
– Carmen Chacón García es Profesora Permanente Laboral en el Departamento de Lengua Española y Teoría de la Literatura de la Universidad Complutense de Madrid.
– Francisco Jesús Fernández es Profesor Extraordinario Consulto de la Universidad Nacional de Salta, Argentina. Se desempeñó en las Cátedras de Griego, Latín, Introducción a la Lingüística e Historia de la Lengua Española.
– José María Guirao es profesor de la ETS de Ingeniería Informática y de Telecomunicación de la Universidad de Granada. Es especialista en aplicaciones para Internet y sistemas basados en web.
– Inmaculada Martínez Martínez es Profesora Permanente Laboral en el Departamento de Filología de la Universidad de Cantabria.
– Pedro Sánchez-Prieto de Borja es Catedrático en la Universidad de Alcalá, donde dirige el Grupo de Investigación de Textos para la Historia del Español. Es Académico Correspondiente de la Real Academia Española.